Інженерна постановка завдання та перевірка результату
Сьогодні переходимо до двох пов'язаних навичок - правильно ставити завдання та доводити результат. Claude Code працює не з абстрактною бесідою, а з файлами, командами та станом Git, тому розпливчасте формулювання тут небезпечніше, ніж здається. Це перехід від "магічних промптів" до короткої інженерної специфікації, яку можна перевірити.
Що дізнаємося:
- що таке task spec і чим він відрізняється від звичайного prompt та від
CLAUDE.md; - як формулювати ціль, scope, non-goals та constraints;
- як збирати пакет доказів та критерії приймання;
- як заздалегідь задавати план перевірки та готовність завдання;
- як вести роботу циклом explore - plan - implement - verify - review.
Рівень 3. Інженерна постановка завдання.
Рівень 4. Критерії приймання, verification plan та анти-патерни prompting.
"Зроби нормально" - це не завдання
У звичайному чаті фраза на кшталт "виправ це місце" ще може спрацювати. Але Claude Code змінює реальні файли, і кожну недомовленість він закриває власними здогадками. Одна розпливчаста фраза - це одразу кілька непомітно ухвалених за вас рішень.
Головний ризик - helpful overreach, корисна самодіяльність за межами завдання. Ви просили додати одне поле, а "заодно" підчищено сусідній код, перейменовано моделі та оновлено серіалізацію. Формально корисно, а насправді ви довго дивитесь у git diff і думаєте, як це відкотити.
Що більше порожнеч у завданні, то ширшим і непередбачуванішим стає підсумковий diff.
Порівняйте два формулювання того самого завдання:
Погано:
Зроби калькулятор, хто скільки винен у ресторані.

Краще:
Збери сторінку "ділимо рахунок": компанія вводить підсумок чека
і кількість людей, кожен бачить свою суму.
Акаунти, історію чеків і поділ за позиціями не роби.
Це і є наскрізний приклад вебінару: сторінка "ділимо рахунок у ресторані", далі - просто спліт рахунку. Зберемо її наживо з нуля: з прохання рівня "зроби нормально" до фіналу виросте чесний контракт. Дорогою з'ясується, що навіть таке побутове завдання ховає кілька пасток.
Робочий договір з Claude
Task specification - це коротка інженерна специфікація одного завдання:
- що змінюємо,
- навіщо,
- де проходять межі,
- який результат вважається правильним.
Не трактат на сорок сторінок, а робочий договір між вами та Claude Code.
Хороша аналогія - технічне завдання майстру:
"Зробіть кухню затишнішою" - це побажання.
"Замінити стільницю, не чіпати проводку, зберегти стару мийку, закінчити до п'ятниці" - уже інженерна постановка. Claude, хоч як дивно, любить другий варіант не менше за людей.
Task spec легко сплутати з CLAUDE.md. Коротко: CLAUDE.md тримає правила всього проєкту, task spec - межі одного завдання; докладно розведемо їх трохи далі.
TASK_SPEC.md - це просто робочий markdown-файл поруч із завданням, а не окрема команда чи фіча Claude Code. Вести його можна в репозиторії, у тикеті або прямо в повідомленні.Каркас завдання: вісім запитань
Щоб task spec не перетворився на потік свідомості, зручно прогнати його через вісім простих запитань:
- що змінюємо;
- навіщо змінюємо;
- де змінюємо;
- що входить у scope;
- що не входить;
- які обмеження діють;
- як перевіримо результат;
- який артефакт потрібен на виході.
Останнє запитання забувають найчастіше: іноді Claude потрібен не код, а аналіз, список зачеплених файлів або короткий план. Ці вісім запитань складаються у структуру task spec - це карта всієї нашої сесії:
За цією картою заведемо й наш спліт: TASK_SPEC.md уже створений, поки в ньому самі заголовки. Далі йдемо блоками й дописуємо по кілька рядків за раз - до фіналу вебінару файл буде заповнений повністю.
Тут легко вдатися в крайнощі. Хороший стиль - підбирати розмір постановки під ризик завдання.
Tiny spec - це не халтура, а компактна постановка, коли завдання справді маленьке і місця для самодіяльності майже немає. Для маленької правки - наприклад, майбутньої одруківки в нашому спліті - достатньо й кількох рядків:
Виправити підпис кнопки `Расчитать` на `Рассчитать`
на сторінці спліта. Крім тексту кнопки нічого не змінювати.
Goal: результат, який можна перевірити
Перший блок task spec - Goal.
Сильна ціль робить результат спостережуваним - його можна перевірити очима, тестом, відповіддю API або поведінкою інтерфейсу. І описує вона поведінку, а не технічне рішення: якщо, читаючи ціль, ви уявляєте код, а не результат, значить, уже перестрибнули в реалізацію. Зручно збирати ціль за формулою:
Хороший goal = хто отримує зміну + яка поведінка змінюється +
де це проявляється + що не повинно випадково змінитися
Відкриваємо наш спліт і пишемо перший запис - ціль за тією самою формулою:
## Ціль і бажаний результат
Компанія в ресторані вводить підсумок чека і кількість людей -
кожен бачить свою суму. Працює в браузері, без встановлення.
Ціль залежить від типу завдання
Здається, що ціль завжди одна - "що хочемо отримати". Насправді в кожного типу завдання своя ознака хорошої цілі:
- фіча - з'явилася нова спостережувана поведінка;
- багфікс - баг більше не відтворюється, і є перевірка, що правильна поведінка повернулася;
- рефакторинг - ззовні нічого не змінилося, всередині код став чистішим;
- тести - з'явився тест, який ловить конкретну поломку;
- документація - опис збігається з реальною поведінкою, приклади запускаються;
- дослідження - відповідь з доказами, а не код;
- крок міграції - перехід відбувся, старе працює, і це перевірено;
- новий проєкт - з'явився мінімальний робочий каркас, який можна запустити й перевірити.
Як зараз і як має бути
Хороша ціль показує напрямок, але не показує розрив між поточним і цільовим станом. А порожнечі Claude охоче закриває припущеннями. Тому до цілі додають два блоки мовою фактів:
Goal - куди хочемо прийти.
Current behavior - що відбувається зараз.
Desired behavior - як виглядає правильний стан.
Корисно одразу записати й те, що не повинно зламатися потім. У нашому спліті поточна поведінка - один чесний рядок: проєкту поки просто немає, і це теж факт. Пишемо обидва блоки:
## Поточна поведінка
Проєкту ще немає, repo порожній.

## Бажана поведінка
Компанія вводить підсумок чека і кількість людей - кожен бачить свою суму.
При порожніх полях розрахунку немає, є підказка.
Гіпотеза не дорівнює факту
Зазирнімо на крок уперед: перша версія спліта вже зібрана за чернеткою спеки, і в ній сплив баг - сума з комою дає NaN замість часток. У голові одразу пояснення: "мабуть, річ у парсингу". Здогадки - це нормально. Погано, коли здогадка записана в task spec як перевірений факт.
Claude не відрізняє здогадку від факту: напишете "проблема в парсингу" - він піде лагодити парсинг, навіть якщо причина не там. Це random patching - правки до перевірки причини, "лікування за фотографією". Розділяйте дві речі:
- evidence (докази) - що ви реально бачили: лог помилки, скриншот, тест, що впав;
- hypothesis - ваша здогадка, чому так відбувається.
Здогадку не ховаємо - позначаємо і просимо спершу перевірити:
Гіпотеза: проблема може бути в парсингу коми.
Спершу перевір, перш ніж редагувати.Хочеться одразу лагодити, але п'ять хвилин перевірки дешевші за годину правок не в тому місці.
Межі завдання
А свободу Claude розуміє широко: щоб досягти результату, він спокійно лізе в сусідні файли, які ви чіпати не просили. На виході - величезний diff, який потім страшно рев'юїти.
Лікується це межами: до цілі додають ще три блоки. Разом вони відповідають на запитання "де саме працюємо":
- Goal - який результат потрібен: без нього агент робить не те;
- Scope - де дозволено змінювати код: тримає diff вузьким;
- Non-goals - що свідомо не чіпаємо. ліки від "заодно виправив ось це";
- Affected area - карта місць, які найімовірніше зачепимо, щоб агент не блукав проєктом наосліп.
Окремо про Scope: це не лише список файлів. Сюди ж входить сценарій користувача, місця в системі, які змінюємо, і перевірки поруч. Зручно, що задати його можна "за змістом" - через екрани, дії та тести, - навіть коли точних шляхів до файлів ви ще не знаєте.
Де закінчується завдання
Тонкість із non-goals: те, що потрібно для цілі, не можна оголосити поза scope - це вже спроба сховатися від власної специфікації. І "нічого зайвого не роби" майже марно - краще прямо назвати підсистеми, які не чіпаємо: акаунти, історію чеків, оплату.
Для affected area точність не потрібна - це чорнова карта, а не контракт: екрани, сервіси, події, таблиці й тести, куди найімовірніше полізуть зміни. Не знаєте проєкт напам'ять? Нормально: попросіть Claude спершу просто перелічити кандидатів, без правок, - і карта готова.
І проста перевірка, чи не розповзлося завдання. Насторожтеся, якщо:
- у scope потрапив цілий модуль замість конкретного шматка;
- у non-goals лише "нічого зайвого" - значить, справжніх меж немає;
- affected area порожній - ви поки не уявляєте, що зачепите;
- у тексті завдання зачастило слово "заодно".
Дописуємо спліт - і чесно вирішуємо, де перша версія зупиниться:
## Межі завдання (scope і non-goals)
Одна сторінка, ділимо підсумок чека порівну.
Non-goals: акаунти, історія чеків, поділ за позиціями замовлення.
Constraints: як робити не можна
Goal дає напрямок, scope - територію, constraints розставляють знаки "сюди не заїжджати". Не плутайте з non-goals: ті - що не входить у завдання, constraints - як не можна розширювати зміну.
Для завдання середнього ризику найчастіше вистачає чотирьох жорстких меж:
- public API (зовнішній контракт коду, на який спираються інші частини системи) - payload можна розширювати безпечно, ламати стару поведінку не можна;
- dependency (зовнішня бібліотека) - не додавати нові без реальної потреби: кожна нова тягне за собою оновлення та ризики;
- migration (зміна схеми бази даних) - чужі міграції не чіпати, за потреби створити лише одну нову;
- diff - тримати невеликим і reviewable, без широкого рефакторингу.
У нового проєкту знаки свої. У спліті рахунку все вміщується в один запис:
## Обмеження і межі змін
Без бекенда і без фреймворків: один HTML-файл,
який відкривається подвійним кліком.
Частина constraints - не заборони, а ритм роботи:
Той самий ритм на кожному завданні й робить поведінку Claude передбачуваною: ви заздалегідь знаєте, на якому кроці він зараз і що покаже наприкінці.
CLAUDE.md vs TASK_SPEC.md
Орієнтир простий: інструкція повторюється в усіх завданнях проєкту - їй місце в CLAUDE.md. Потрібна лише для одного завдання - у TASK_SPEC.md.
Порівняйте живі правила з обох боків:
CLAUDE.md:- "стек: чистий HTML і JS, без збірки";
- "підписи на сторінці - російською";
- "показуй змінені файли після правок".
TASK_SPEC.md:- "не змінювати формулу поділу порівну";
- "без нових залежностей";
- "сторінка й далі відкривається подвійним кліком".
Правило не зобов'язане лишитися там, де з'явилося: те, що ви раз по раз пишете в TASK_SPEC.md, з часом доростає до CLAUDE.md і перестає повторюватися вручну.
Constraints у task spec - дорожній знак, а не відбійник: вони спрямовують, але не блокують. Жорстке блокування дають permissions сесії та захищені шляхи - їх ми розбирали на Рівні 2.
Пакет доказів
Знову крокнемо вперед, до живої першої версії спліта. Типова скарга на баг звучить так: "спліт іноді рахує дивно". Колезі цього вистачить - деталі, яких бракує, він додумає з досвіду. Claude додумувати нічим: у фразі немає ні кроків, ні файлів, ні тексту помилки. Без фактів він реагує на вашу інтонацію "щось не так", а не на саму проблему. Тому перед роботою збираємо пакет доказів.
Контекст - усе, що Claude використовує в роботі.
Evidence - те, що підтверджує результат.
Контекст допомагає думати, evidence - доводити, решта - шум.
Пакет не зобов'язаний бути великим - це не досьє на проєкт, а кілька фактів під одне завдання:
- кроки відтворення - як саме отримати помилку;
- зачеплені файли - щоб обмежити область пошуку;
- лог, stack trace або скриншот - технічний сигнал, а не враження;
- наявний тест і схожа реалізація - що вже перевіряється і який патерн використати.
Зручно тримати їх в одному місці - файлі EVIDENCE_LOG.md поруч із завданням. Він відповідає на чотири запитання: що ламається, як відтворити, де зона, чим перевіримо:
# EVIDENCE_LOG.md

## Завдання
При сумі чека з комою сторінка показує NaN замість часток.

## Відтворення
1. Відкрити сторінку спліта
2. Ввести підсумок `1 000,50` і трьох людей
3. Замість сум часток - NaN

## Факти
- вся логіка: index.html
- скриншот: nan-split.png
- помилка в console: parseFloat повернув NaN
- поле "кількість людей" той самий рядок парсить правильно
Пакет достатній, коли без гадання відповідаєте на всі чотири запитання: немає відповіді хоча б на одне - у реалізацію рано. Відкриті запитання файл не псують - показують, де ще розслідування.
І другий експонат пакета - контрольний чек: підсумок 1000, компанія з трьох людей. Він же стане тестовими даними в плані перевірки. Числа вибрані не випадково - чому саме такі, побачимо на критеріях приймання.
Критерії приймання: що вважати готовим
Вони перетворюють "зроби краще" на "ось що має стати правдою після зміни": умови виконалися - приймаємо, ні - продовжуємо, без суперечок "ну загалом же краще".
Головне: критерій описує поведінку, а не реалізацію - не яким способом Claude зробить це всередині коду, а що побачить користувач або система.
Відрізнити хороший критерій від розпливчастого допомагають п'ять ознак:
- спостережуваність - результат видно в UI, API, лозі або поведінці;
- конкретність - "при порожніх полях розрахунок не запускається", а не "валідація стала кращою";
- одна думка на рядок - окремо про підказку під полем, окремо про сам розрахунок;
- незалежність від реалізації - "кома вважається десятковим роздільником", а не "замінити кому на крапку перед parseFloat";
- збереження поведінки - зафіксовано, що не повинно зламатися.
"Зроби калькулятор зручнішим" можна тільки обговорювати; "при порожніх полях розрахунку немає і є підказка під полем" - перевірити за три секунди.
І про повноту набору: один критерій "запрацювало" завдання рідко закриває. Claude уміє лагодити одне й зачіпати сусіднє, тому тримайте хоча б три фільтри - що запрацює, що не зламається і що побачить користувач.
Перевіримо на спліті. Чернетка критеріїв звучить гладко:
## Критерії приймання
Сума часток дорівнює підсумку чека - копійка в копійку.
Порожні поля або нуль людей - розрахунку немає, є підказка.
А тепер прогоніть через них контрольний чек: 1000 на трьох порівну не ділиться. Перш ніж розкривати відповідь, прикиньте самі, що покаже сторінка.
Що ховається в контрольному чеку
333.33 + 333.33 + 333.34: зайва копійка дістається комусь одному, а в чернетці про це ні слова - як і про чайові. Обидві діри залишені в спеці навмисно: трохи далі їх знайде сам Claude.
"Готово" від Claude - ще не фінал
"Готово" від моделі саме по собі майже нічого не означає - як із чайником після ремонту: ви все одно вмикаєте і перевіряєте, чи гріє. Тому додаємо дві опори, обидві пишуться до коду:
- план перевірки відповідає на запитання "як перевіряємо": які команди запустити, який тест з'явиться або зміниться, яку відповідь очікуємо і що вважаємо провалом;
- готовність завдання відповідає на запитання "коли вважаємо завершеним": не тільки "чи працює", а й "чи можна це приймати" - scope, чистий diff, оновлена документація, ризики, human review.
Чому до коду? План перевірки, написаний після diff, непомітно підлаштовується під результат - як побудувати міст і потім вирішити, яку вагу він "мав би" витримати. План заздалегідь - захист від самообману.
Схема не дає перестрибнути через щаблі, особливо "одразу в реалізацію": критерії - що має стати правдою, план перевірки - як довести, готовність - коли завдання завершене. Ось як ці два блоки виглядають у task spec:
## План перевірки
- відкрити сторінку і прогнати контрольний чек: 1000 на трьох
- перевірити порожні поля і компанію з однієї людини
- звірити: сума часток дорівнює підсумку чека

## Готовність завдання
- diff у межах scope, немає зайвих файлів
- контрольний чек сходиться
- ризики записані
- diff прочитаний людиною до merge
Від дослідження до commit
Найдорожче обходиться не поганий код, а поганий порядок роботи: план виправити дешевше, ніж код. Перед правками беремо паузу - "досліди, як у першій версії спліта влаштовані поділ і округлення: назви файли, ризики та план, код не змінюй". Так починається plan-first.
Цикл не лінійний: впали перевірки на verify або поплив scope на review - повертаємося до плану, а не "дотискаємо". Implement ведемо по одному кроку: маленький diff легше перевірити та відкотити.
Повний цикл потрібен не для всього: одрук або очевидний однорядковий фікс можна робити коротше, а от незнайомий код, оплату чи зміни в кількох файлах - завжди через plan-first.
Permission mode не замінює plan-first: швидкий хаос - усе ще хаос, просто швидше.
Хай Claude ставить запитання
Коли завдання не вміщається в один запит, зручний Claude interview pattern: приносите заготовку і просите Claude поставити уточнювальні запитання. Заготовка - це буквально три фрази:
Я хочу отримати: {опис результату та критерії успіху}.

Спершу постав мені запитання - стільки, скільки потрібно,
щоб зібрати інформацію для детального плану.

Коли інформації вистачить, запропонуй покроковий план
досягнення цього результату.До речі, цей прийом уже запакований у готовий інструмент - brainstorming skill від obra, але про skills поговоримо пізніше.
Запитання витягують неочевидне - не тільки код, але й налаштування, UX, межі завдання, про які ви самі б не згадали.
Саме сюди ми приносимо чернетку спліта: ті самі три фрази плюс файл спеки - і Claude починає питати. Діри, які ми залишили в критеріях, живуть рівно до цього моменту.
Запитання, які спливли на нашому прогоні
- чайові - входять у підсумок чека чи додаються зверху;
- куди подіти зайву копійку при поділі порівну;
- порівну чи за позиціями замовлення - у нас уже відповіли в non-goals, і Claude це бачить зі спеки;
- що показувати, коли в компанії одна людина.
Реалізацію запускайте в новій чистій сесії: у старій осіли чорнові гіпотези з обговорення, і вони непомітно впливають на підсумковий diff. Перед виходом із сесії, де збирали TASK_SPEC.md, попросіть Claude написати стартовий prompt для нової сесії: ціль, шлях до специфікації, важливі рішення та обмеження. Так нова сесія стартує швидше й отримує потрібний context без шуму обговорення.
Запитання працюють в обидва боки
Питати має не тільки Claude, але й ви. Сумніваєтеся в підході або не знаєте, як щось зробити - не гадайте і не відкладайте: поставте запитання прямо в сесії. Claude пояснить незнайоме місце, запропонує варіанти і допоможе довести формулювання до робочого.
Фінальний TASK_SPEC.md
Усі блоки, які ми розібрали, збираються в один контракт: згори постановка, нижче факти, критерії та перевірка. Працює він лише за чесного заповнення - специфікація "для галочки" лишається гарним, але марним ритуалом.
Ось фінальна спека нашого спліта рахунку - тієї самої сторінки, що виросла з "зроби калькулятор, хто скільки винен":
# TASK_SPEC.md
## Ціль і бажаний результат
Компанія в ресторані вводить підсумок чека і кількість людей -
кожен бачить свою суму. Працює в браузері, без встановлення.

## Поточна поведінка і бажана
Проєкту ще немає, repo порожній. Потрібна перша версія: одна сторінка.

## Межі завдання (scope і non-goals)
Одна сторінка, ділимо підсумок чека порівну.
Non-goals: акаунти, історія чеків, поділ за позиціями замовлення.

## Обмеження і межі змін
Без бекенда і без фреймворків: один HTML-файл.

## Пакет доказів
Контрольний чек: підсумок 1000, компанія з трьох людей.

## Критерії приймання
Сума часток дорівнює підсумку чека - копійка в копійку.
Чайові задаються відсотком і входять у поділ.
Зайва копійка округлення дістається першій частці, це видно на сторінці.
Порожні поля або нуль людей - розрахунку немає, є підказка.

## План перевірки
Прогнати контрольний чек: 1000 на трьох, з чайовими і без.
Перевірити порожні поля і компанію з однієї людини.

## Готовність завдання
Сторінка відкривається подвійним кліком, суми сходяться,
diff прочитаний людиною до merge.

## Очікуваний порядок роботи
Спершу план, після підтвердження - реалізація по кроках.

## Очікуваний артефакт
Один HTML-файл і короткий опис, як перевірити.
Зверніть увагу на рядки про чайові й копійку: у чернетці їх не було - їх принесли запитання Claude. Це і є ціна interview: дві діри, які інакше спливли б тільки після "готово".
Ми будували з нуля, тому спека відповідала на "що будуємо": що увійде в першу версію, які рамки задані одразу, коли перший шматок готовий. Для правки в живому коді каркас той самий - тільки замість "що будуємо" питаємо "що змінюємо", а замість обсягу першої версії малюємо межі в наявному коді. Наш non-goal "поділ за позиціями" колись доросте до такого завдання - і отримає власний TASK_SPEC.md за цим самим каркасом.
Не лякайтеся кількості секцій: для маленького завдання tiny spec із кількох рядків - теж чесний контракт.
З новим проєктом є й чесна складність: зрозуміти одразу, якими мають бути вимоги, дуже важко, а іноді майже неможливо - ви ще не бачили систему наживо і не знаєте, що виявиться зручним, а що зайвим. Це нормально і не привід вичавлювати з себе ідеальну постановку з першого разу.
Таку чернетку можна подивитися, помацати руками, зрозуміти, чого насправді хочеться, - і переписати проєкт заново, уже з усвідомленими вимогами. Перша версія тут не результат, а спосіб побачити завдання ясніше. Наш спліт пройшов рівно цей шлях: перша версія з пісочниці зловила баг із комою і підказала, чого бракувало в постановці.
Перед будь-яким завданням достатньо трьох запитань:
- Що має стати правдою - критерії приймання.
- Як я це доведу - план перевірки.
- Коли завдання завершене цілком - готовність завдання.
Практика - ваше завдання
Далі працюєте самі: задана лише високорівнева ціль, а весь шлях до неї проходите ви.
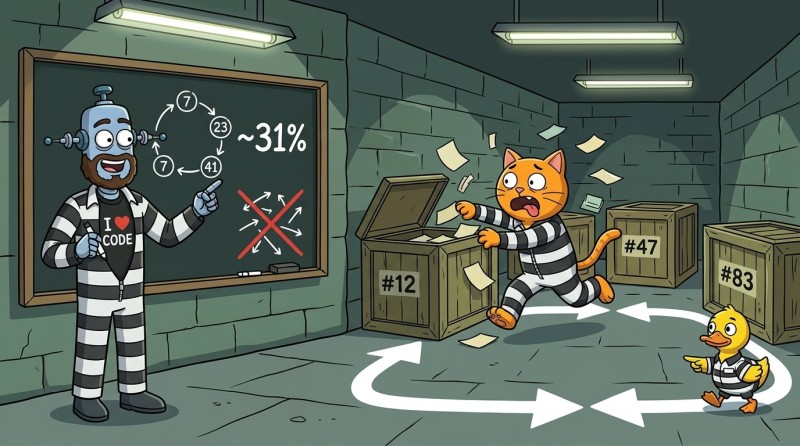
Ціль: зібрати дві інтерактивні симуляції у форматі 8-біт, які працюють прямо в браузері. Обидві ґрунтуються на відомих задачах із роликів Veritasium:
- "100 в'язнів і 100 скриньок" - імовірнісний парадокс про стратегію пошуку: 100 пронумерованих в'язнів і 100 скриньок, де їхні номери розкладені випадково; кожному можна відкрити лише половину скриньок і знайти всередині свій номер - і врятуватися мають усі разом: варто помилитися одному, програють усі;
- "Теорія ігор" - це не одиночний прогон, а турнір стратегій у повторюваній дилемі в'язня: кілька ботів із різними стратегіями (наприклад, "завжди співпрацювати", "завжди зраджувати", "око за око") грають кожен з кожним на безлічі раундів, а ви за таблицею очок дивитеся, хто кого обігрує і чому.
І ще одна вимога до результату.
Симуляція має не просто відтворювати задачу, а доводити до її найкращого рішення. Закладіть стратегії і дайте їх порівняти: для в'язнів це щонайменше дві - сліпий випадковий перебір проти стратегії циклів, щоб розрив у шансах впадав у вічі; для теорії ігор це цілий набір ботів у турнірі, де сильна стратегія спливає сама, коли ви стравлюєте їх одне з одним. Ця "правильна" стратегія і є тим, заради чого таку симуляцію цікаво запускати.
З чого почати. Якщо робите обидві, почніть зі "100 в'язнів": ядро тут просте і впирається в одне тверде число (~31%), а основна робота - у 8-біт анімації. "Теорія ігор" - більший білд: потрібні набір стратегій, турнірний рушій і таблиця результатів, зате як інженерна постановка вона багатша.
Розбити завдання на етапи, написати промпти і TASK_SPEC, обрати стек - ваша робота.
Практика - етап 1
Перший крок - не код, а дослідження. Найімовірніше, про ці задачі ви поки не знаєте майже нічого - це нормальна стартова точка, і починаємо ми саме з неї. Поки ви не розумієте задачу, поставити її неможливо: обидві тримаються на неочевидній математиці, і "зробити щось про в'язнів" - це ще не завдання.
Спершу розберіться в задачах і складіть дані у файли
Вивчіть не лише суть, а й найкращі техніки і рішення кожної задачі, і складайте знайдене у файли проєкту: так збереться свій пакет доказів, на який ви спиратиметеся в постановці, а не на пам'ять.
100 в'язнів
Розберіться, чому за сліпого перебору шанс врятуватися всім одразу зникомо малий - це (1/2) у сотому степені, практично нуль, - а стратегія циклів (loop strategy) піднімає його до ~31%.
Уся хитрість у тому, що в'язень іде по скриньках не навмання: стартує зі скриньки зі своїм номером і щоразу переходить до скриньки з тим номером, що знайшов усередині. Усі рятуються рівно тоді, коли в розкладці немає жодного циклу, довшого за 50. Подивіться ролик Veritasium про 100 в'язнів і 100 скриньок.
Теорія ігор
Повторювана дилема в'язня і турнір Аксельрода - круговий турнір, де кожна стратегія грає з кожною. Розберіть матрицю очок (обопільна співпраця - 3/3, обопільна зрада - 1/1, одностороння зрада - 5/0) і чому просте "око за око" (tit-for-tat) обігрує решту за сумою.
Його сила - у чотирьох властивостях: добре (не зраджує першим), мстиве (одразу карає за зраду), відхідливе (повертається до співпраці, щойно суперник перестав зраджувати) і зрозуміле (передбачуване, з ним легко налагодити співпрацю). Подивіться ролик Veritasium "Теорія ігор: життя, Всесвіт і все інше".
Витягніть дані через Claude interview
Використайте прийом зі слайда "Хай Claude ставить запитання": принесіть заготовку і попросіть Claude поставити запитання - так спливе неочевидне (правила, стани, UX, межі). Ось стартова заготовка, далі ведіть розмову самі:
Я хочу зібрати 8-бітну браузерну симуляцію за задачею
"100 в'язнів і 100 скриньок".

Спершу постав мені запитання - стільки, скільки потрібно,
щоб зрозуміти правила, стани і критерії успіху.

Коли інформації вистачить, запропонуй покроковий план.Практика - етап 2
Зрозумілу задачу перетворіть на інженерну постановку - це серце вебінару. На кожну симуляцію зберіть свій TASK_SPEC.md за тим самим каркасом, що ми розібрали: goal, scope і non-goals, обмеження, критерії приймання, план перевірки, готовність.
Придумайте це самі
Готових промптів тут немає - замість них орієнтири, на які відповідаєте ви:
- Scope і non-goals - де свідомо зупинитися?
одна ключова механіка на симуляцію; меню, таблиця рекордів і звук - перші кандидати в non-goals. - "8-біт" і "в браузері" - як зафіксувати це в перевірюваних словах, щоб Claude не додумав сам?
"8-біт" - обмежена палітра, піксельний шрифт, великі пікселі; "в браузері" - відкривається з index.html без збірки і сервера. - Критерії приймання - що зробить "готово" перевірюваним, а не "на око"?
формулюйте через спостережуване: "стратегія циклів на 100 прогонах дає близько 31% перемог" або "у турнірі 'око за око' стабільно у верхівці таблиці, а 'завжди зраджувати' - у хвості", а не "воно працює". - Milestones - як розбити симуляцію на кроки з перевіркою в кінці кожного?
перший крок - робоча логіка в найпростішому вигляді (рахує результат), 8-біт оформлення навішується потім.
Далі ведіть роботу циклом explore - plan - implement - verify - review, по одному milestone за раз. План перевірки задавайте до реалізації, а не після.
Практика - хард
Із зірочкою, для тих, хто хоче довести до кінця: зробіть свої симуляції доступними за посиланням - задеплойте їх на безкоштовний хостинг, щоб відкривалися в будь-кого, а не тільки у вас локально. Не тягнете обидві - доведіть до мережі хоча б одну.
Куди можна безкоштовно деплоїти
- itch.io - профільний майданчик для браузерних ігор та інтерактиву, приймає HTML5-збірку;
- GitHub Pages - статичний хостинг прямо з репозиторію;
- Netlify або Vercel - деплой перетягуванням теки або з git.
Симуляція відкривається за публічним URL у режимі інкогніто, без локального сервера, і працює з телефона.